Nvidia wprowadza najpotężniejszy akcelerator obliczeniowy – to prawdziwy mocarz
Nvidia wprowadza najpotężniejszy akcelerator obliczeniowy – to prawdziwy mocarz
Czekaliśmy, czekaliśmy i się doczekaliśmy! Nvidia oficjalnie zaprezentowała architekturę Hopper, która znajdzie zastosowanie w akceleratorach obliczeniowych – producent mówi o ogromnym wzroście wydajności, która pozwoli zrewolucjonizować ten rynek.
Podczas konferencji GTC 2022 poznaliśmy pierwsze szczegóły na temat układów graficznych z generacji Nvidia Hopper (nazwanych na cześć Grace Hopper, pionierki amerykańskiej informatyki). Nowa architektura ma zadanie przyspieszyć operacje programowania dynamicznego — technikę rozwiązywania problemów wykorzystywaną w algorytmach genomiki, obliczeniach kwantowych i optymalizacji tras.
Nowe układy graficzne znajdą zastosowanie w systemach obliczeniowych i superkomputerach. Warto jednak bliżej przyjrzeć się temu co zaprezentowała Nvidia.
Architektura Nvidia Hopper. Jest moc!
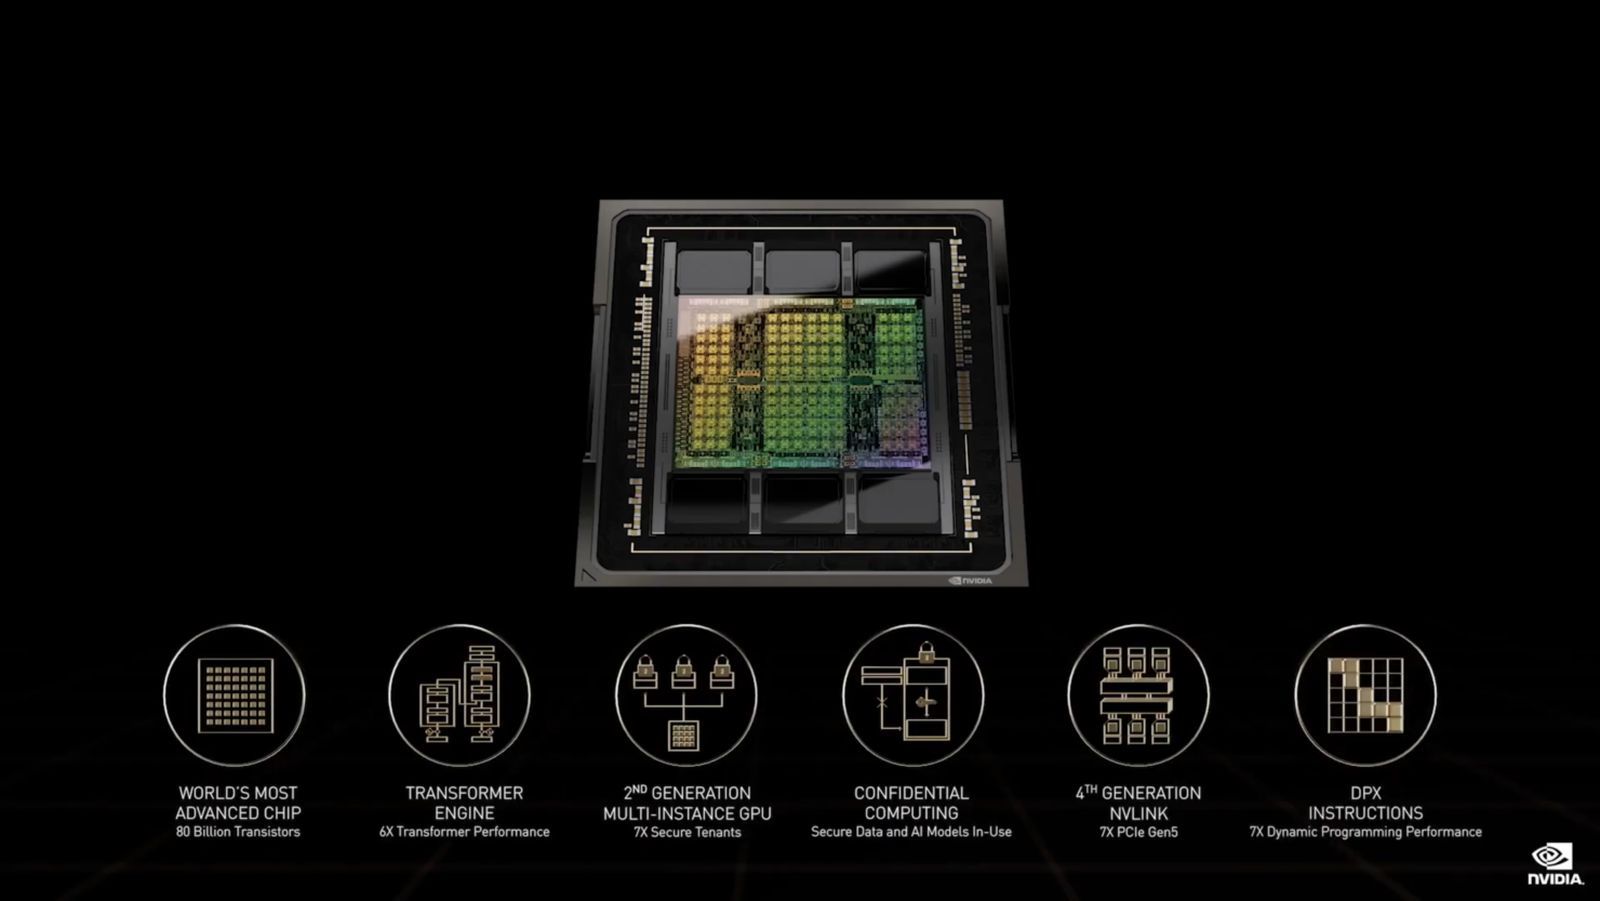
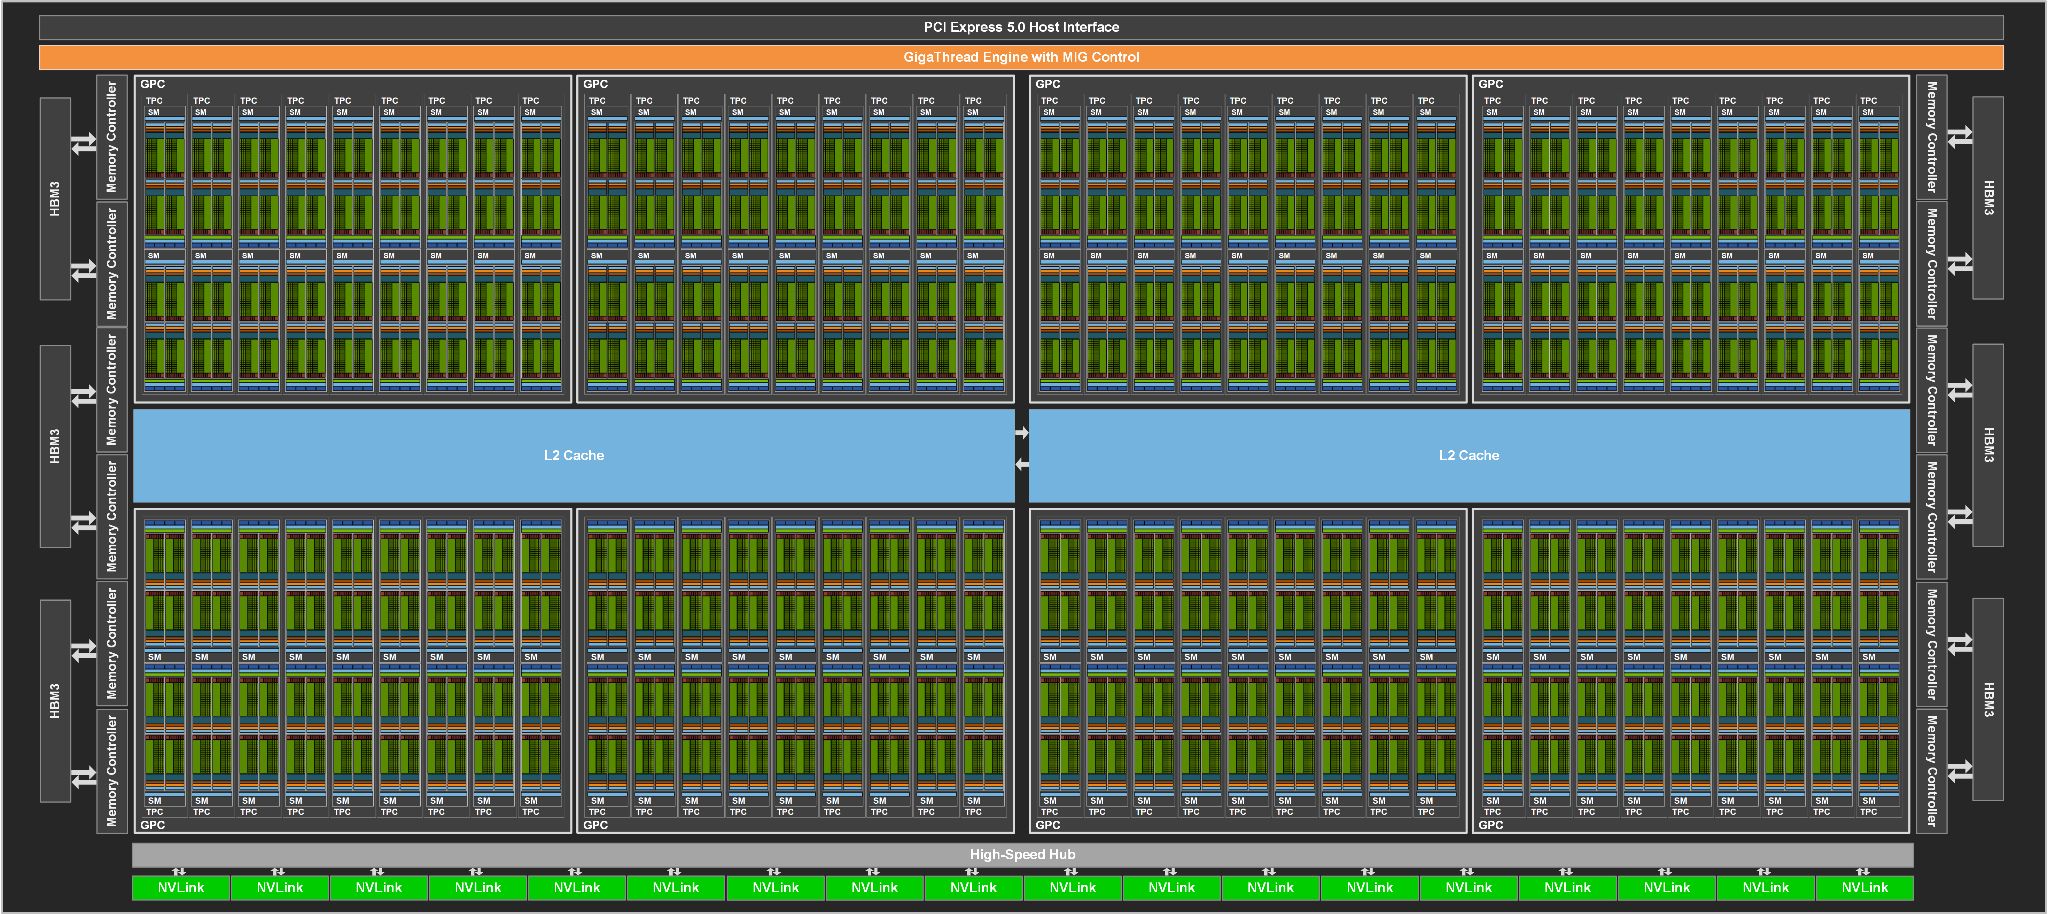
Nowa architektura została zaprojektowana typowo z myślą o systemach obliczeniowych. Póki co producent przygotował jeden układ graficzny – to rdzeń GH100, który został wykonany w 4-nanometrowej litografii TSMC (TSMC N4) i składa się z 80 miliardów tranzystorów (układ ma powierzchnię 814 mm2, czyli zbliżoną do rdzenia GA100 – podobnego układu z generacji Nvidia Ampere).
Nvidia Hopper GH100 - budowa procesora graficznego
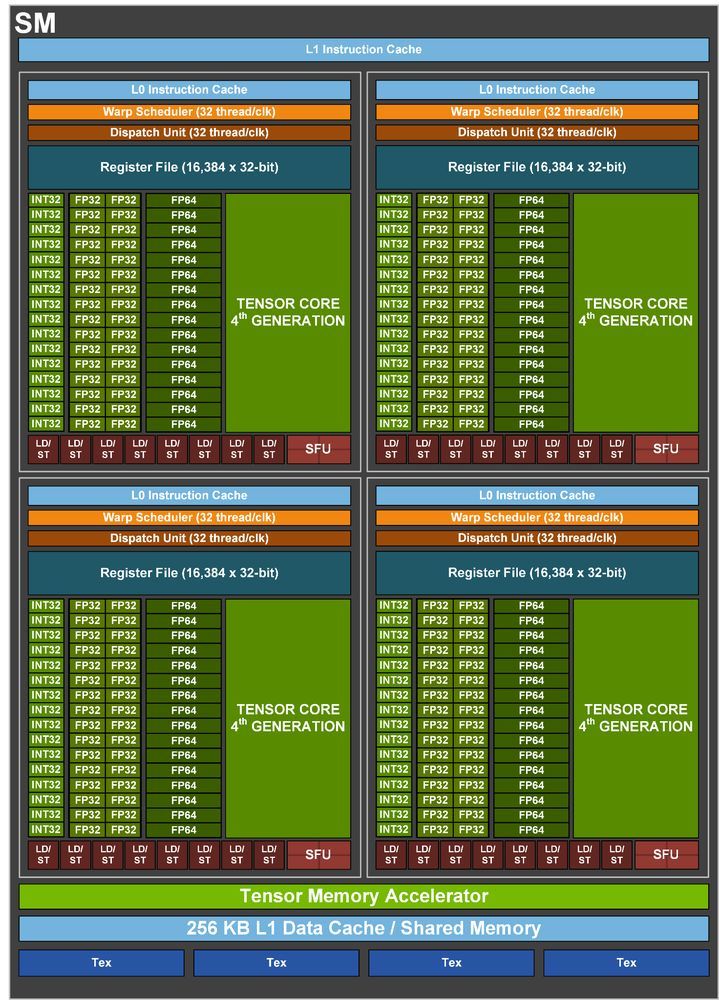
Nvidia Hopper - budowa bloku SM
Procesor graficzny GH100 oferuje też potężną specyfikację. Cały układ graficzny obejmuje 18 432 rdzeni CUDA i 576 rdzeni Tensor (4. generacji), a ponadto przewidziano 96 GB pamięci HBM3/HBM2e 6144-bit.
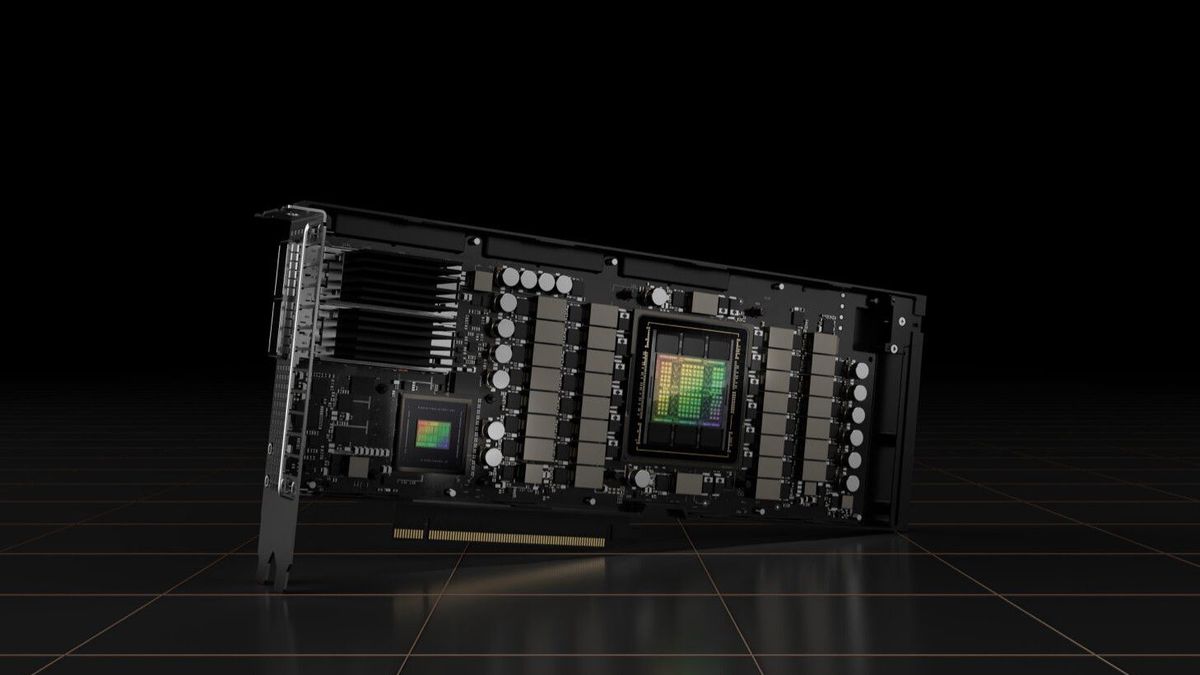
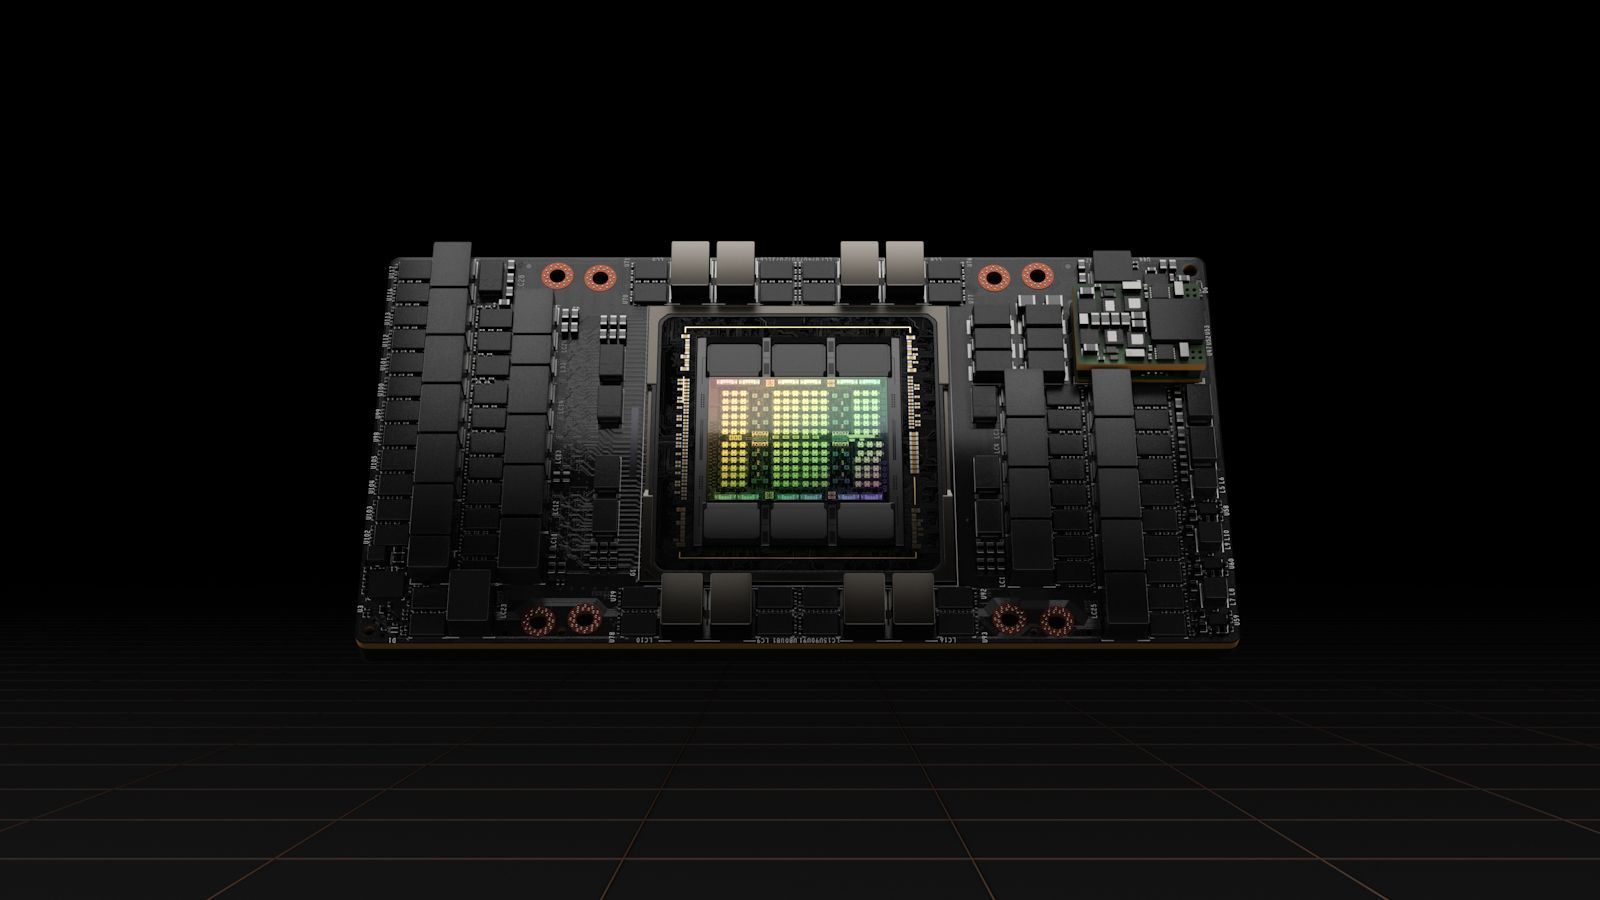
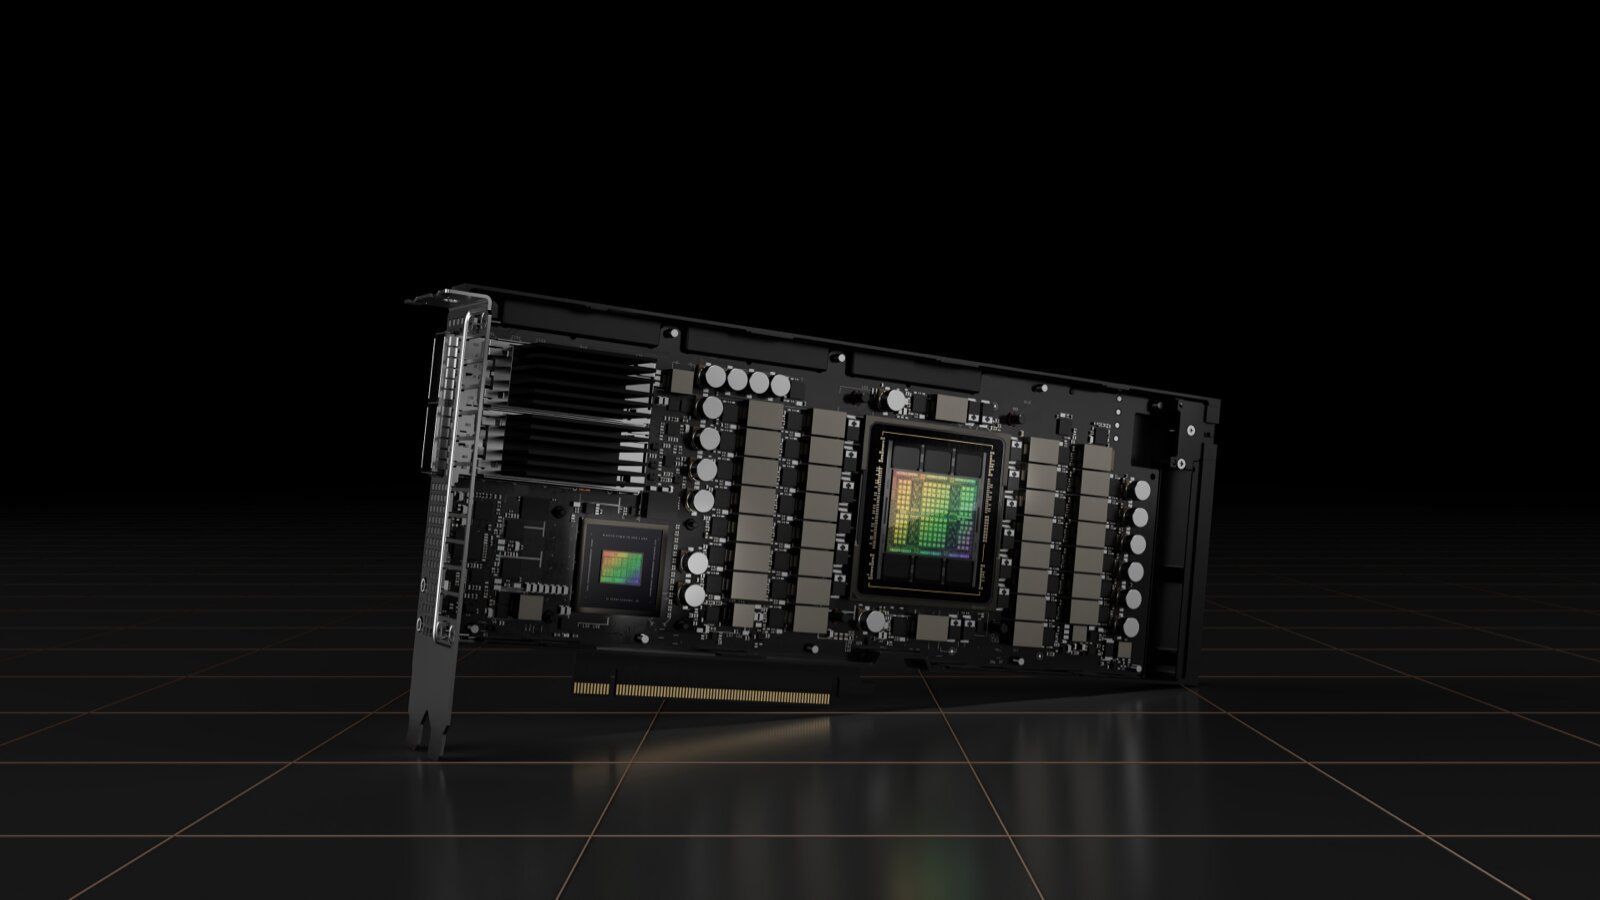
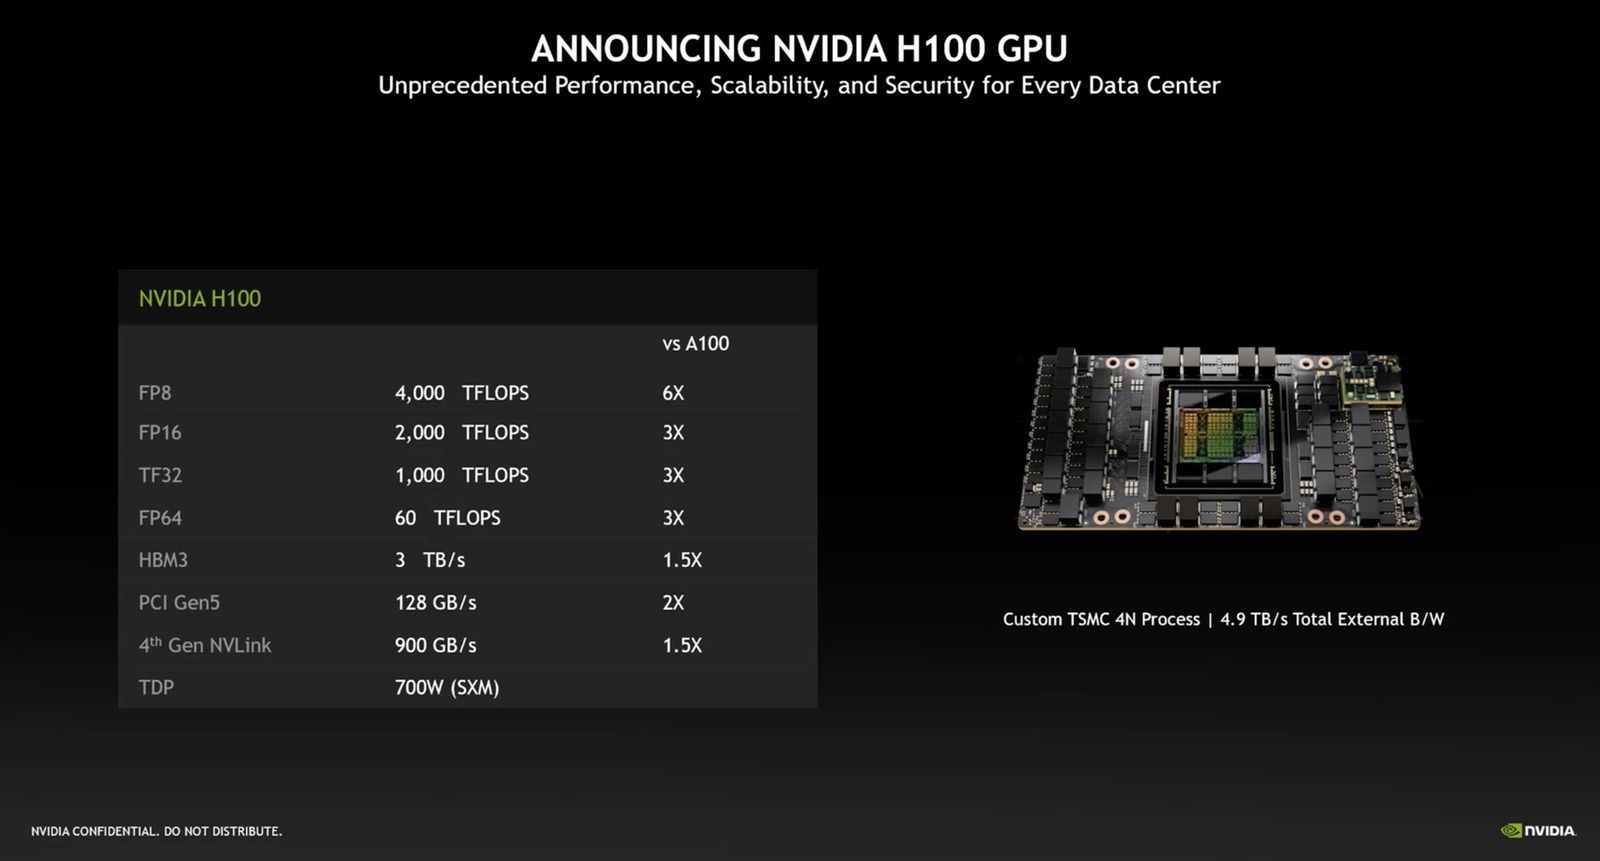
Nowy układ graficzny posłużył do budowy profesjonalnego akceleratora obliczeniowego Nvidia H100 – jest on dostępny w postaci modułu SXM5 oraz karty rozszerzeń pod PCI-Express 5.0. Warto jednak zaznaczyć, że druga wersja oferuje gorszą specyfikację (ale też cechuje się dużo mniejszym zapotrzebowaniem na energię elektryczną).
Model
Nvidia A100 (SXM)
Nvidia H100 (SXM)
Nvidia H100 (PCIe)
Generacja
Nvidia Ampere
Nvidia Hopper
Nvidia Hopper
Litografia
TSMC N7
TSMC N4
TSMC N4
Układ graficzny
Ampere GA100
Hopper GH100
Hopper GH100
Rdzenie CUDA
6912
15872
14592
Rdzenie Tensor
432
528
456
Wydajność FP64
9,7 TFLOPS
30 TFLOPS
24 TFLOPS
Wydajność FP64 Tensor
19,5 TFLOPS
60 TFLOPS
48 TFLOPS
Wydajność FP32
19,5 TFLOPS
60 TFLOPS
48 TFLOPS
Wydajność FP32 Tensor
312 TFLOPS
1000 TFLOPS
800 TFLOPS
Wydajność INT32
19,5 TOPS
30 TOPS
24 TOPS
Wydajność INT8 Tensor
1248 TOPS
4000 TOPS
3200 TOPS
Pamięć VRAM
80GB HBM2e 5120-bit
80 GB HBM3 5120-bit
80 GB HBM2e 5120-bit
Przepustowość pamięci
1,55 TB/s
3 TB/s
2 TB/s
TDP
400 W
700 W
350 W
Akcelerator Nvidia H100 w postaci modułu SXM5
Akcelerator Nvidia H100 w postaci karty rozszerzeń pod PCI-Express
Wydajność karty robi ogromne wrażenie – to największa i najpotężniejsza konstrukcja, jaka została przygotowana przez „zielonych”.
Producent chwali się, że akcelerator Nvidia H100 (SXM) oferuje 3-krotnie wyższą wydajność obliczeniową FP64, TF32, FP16 oraz 6-krotnie wyższą FP8 względem akceleratora Nvidia A100 (poprzednika z generacji Ampere). Przepustowość pamięci wzrosła 1,5-krotnie.
Warto dodać, że akcelerator Nvidia H100 jest obsługiwany przez wszystkie najważniejsze narzędzia programistyczne, dzięki czemu można go używać do przyspieszania aplikacji od AI po HPC (z tej też okazji producent wydał ponad 60 aktualizacji swoich bibliotek programistycznych, które przyspieszą prace w zakresie obliczeń kwantowych, genomiki, odkrywania nowych leków, cyberbezpieczeństwa czy badań nad 6G)
Dostępność kart Nvidia H100
Akceleratory Nvidia H100 mogą być wdrożone w centrach danych i systemach chmurowych. Oczekuje się, że takie konstrukcje będą dostępne jeszcze w tym roku u wiodących dostawców usług w chmurze i producentów sprzętu.
Nvidia daje możliwość połączenia nawet 32 systemów DGX H100
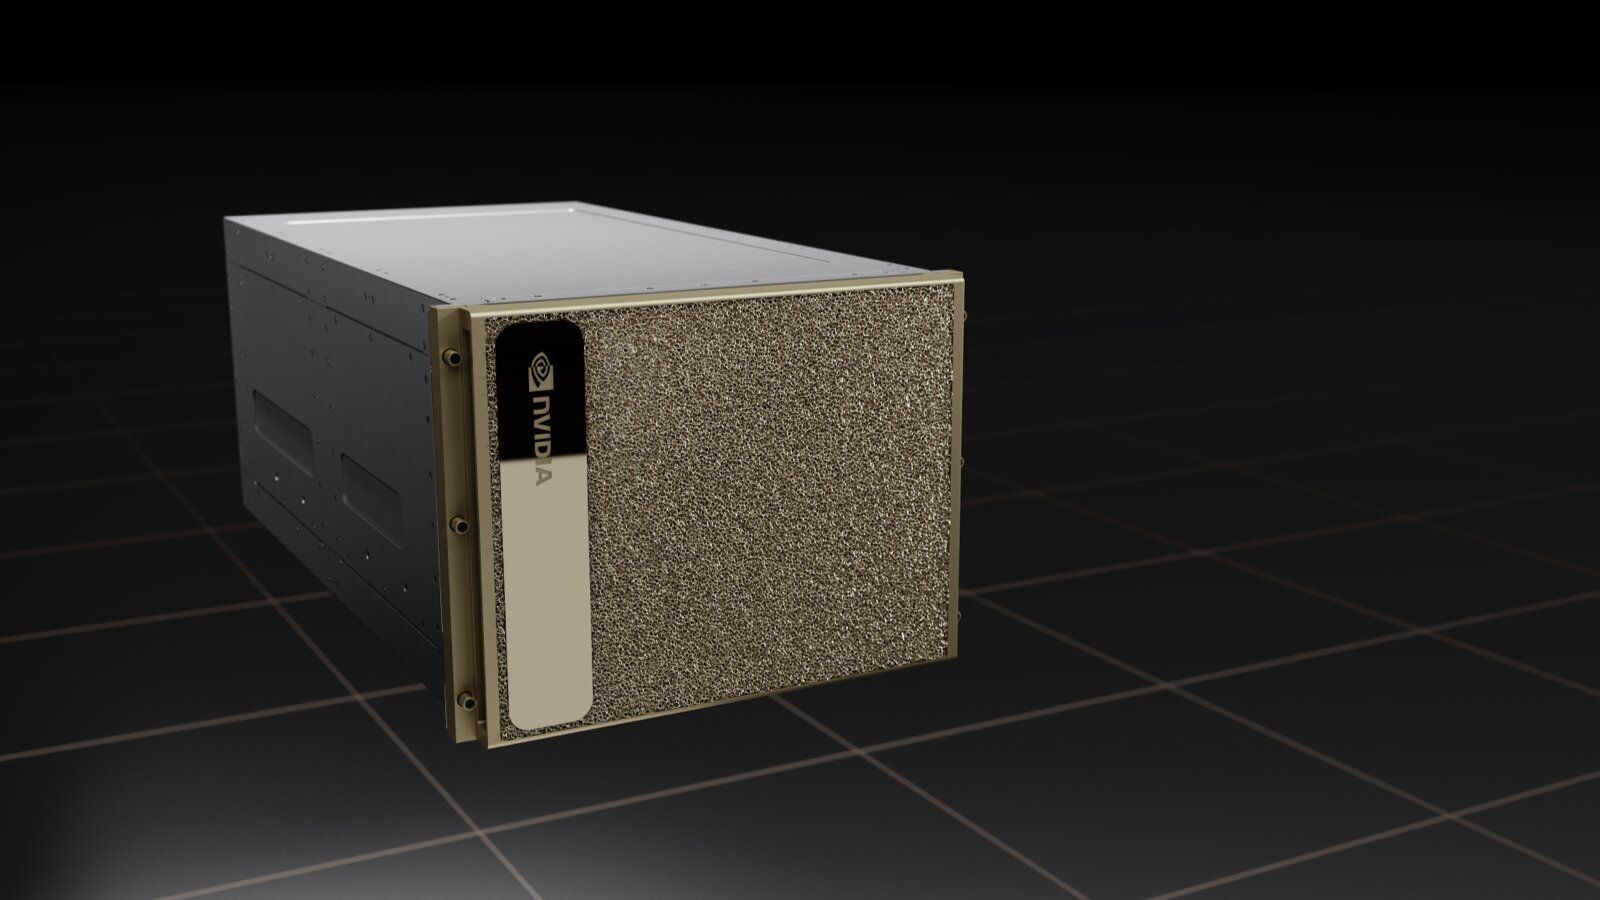
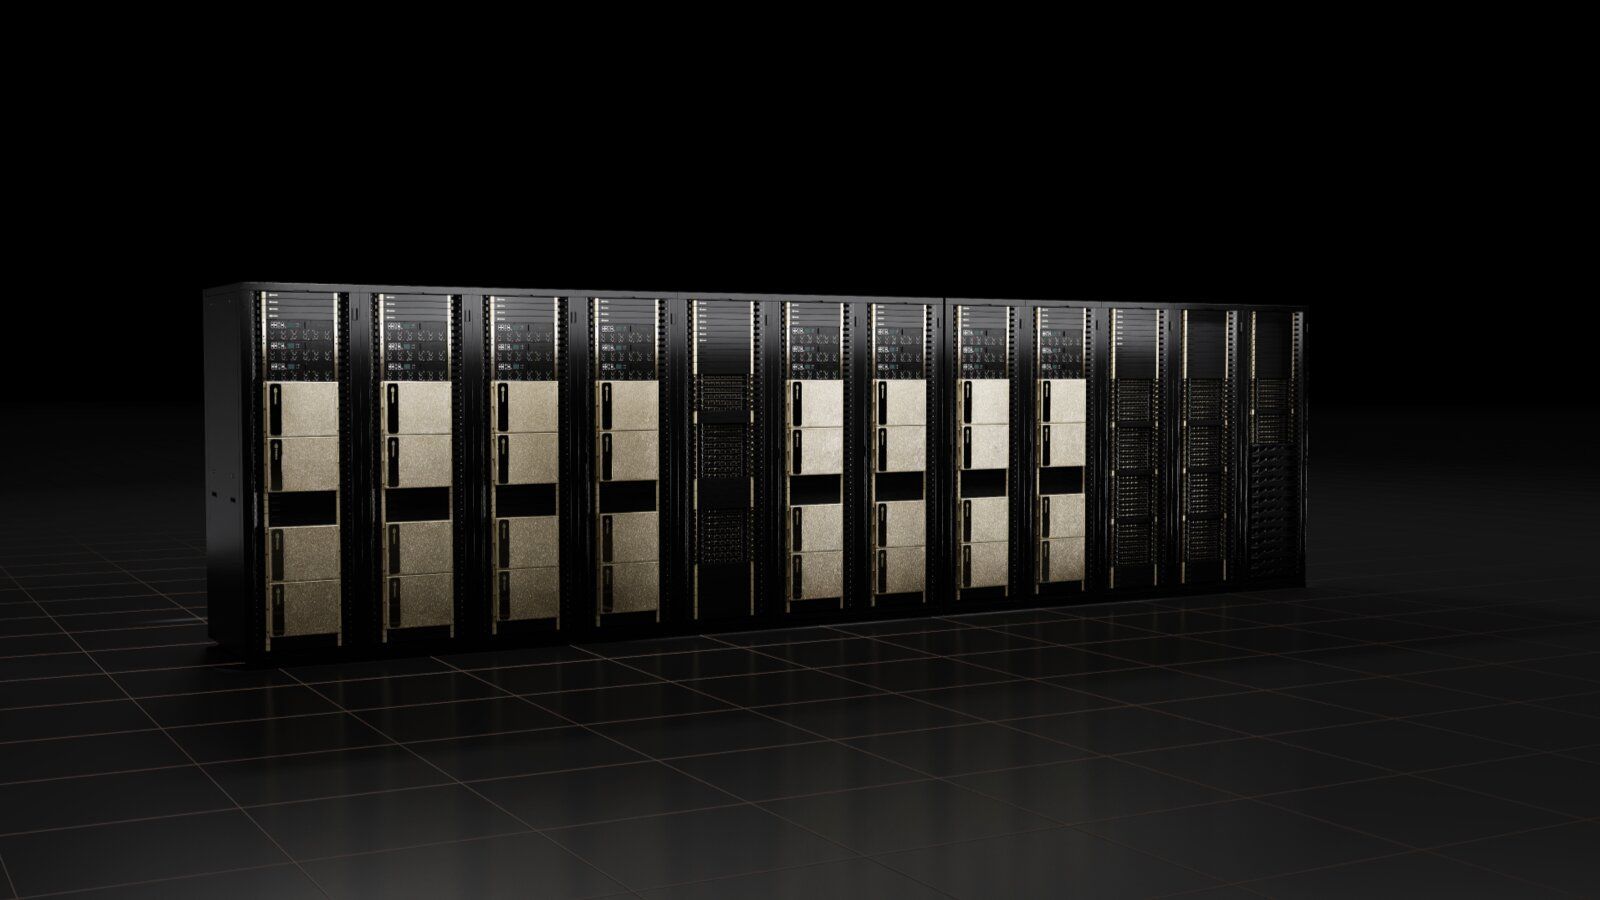
Przy okazji zaprezentowano też nowy system obliczeniowy DGX H100, który został wyposażony w osiem akceleratorów obliczeniowych Nvidia H100 - zostały one połączone za pomocą łącza NVLink czwartej generacji (dzięki zewnętrznemu przełącznikowi NVLInk można też połączyć do 32 węzłów DGX H100 w superkomputer Nvidia DGX Super POD).
Jeśli jesteście zainteresowani szczegółami, poniżej możecie zobaczyć powtórkę konferencji GTC 2022, na której zaprezentowano nowe akceleratory Nvidia Hopper.
WIDEO
Źródło: Nvidia, ComputerBase, WCCFTech
Paweł MaziarzRedaktor prowadzący serwis benchmark.pl
Redaktor prowadzący serwis Benchmark.pl, dziennikarz technologiczny z ponad 15-letnim doświadczeniem. Specjalizuje się w tematach związanych ze sprzętem komputerowym, rozwojem technologii AI oraz trendami w branży IT. W swojej pracy stawia na rzetelność, praktyczne podejście i pasję do nowinek technologicznych, koncentrując się na ocenie produktów pod kątem ich wartości i opłacalności dla użytkowników. W wolnym czasie angażuje się w wolontariat, aktywnie spędza czas oraz rozwija swoje zainteresowania i pasje.